Yann LeCun:智能的本质是统计,但必须是特定类型的统计

杨立昆与Lex Fridman深入探讨自监督学习为何是通往机器智能的关键路径。他认为,当前监督学习和强化学习效率低下,无法解释人类和动物如何高效学习。自监督学习通过“填补空白”(如预测视频下一帧)来构建世界模型,是从观察中获取背景知识的核心机制。杨立昆指出,尽管在语言领域已取得巨大成功,但让机器从视频中学习世界表征仍是巨大挑战。他强调,智能或许本质上是一种特定类型的统计,但必须能学习包含因果关系的、可微分的世界模型,这是未来十年AI研究的核心目标。

杨立昆

导语

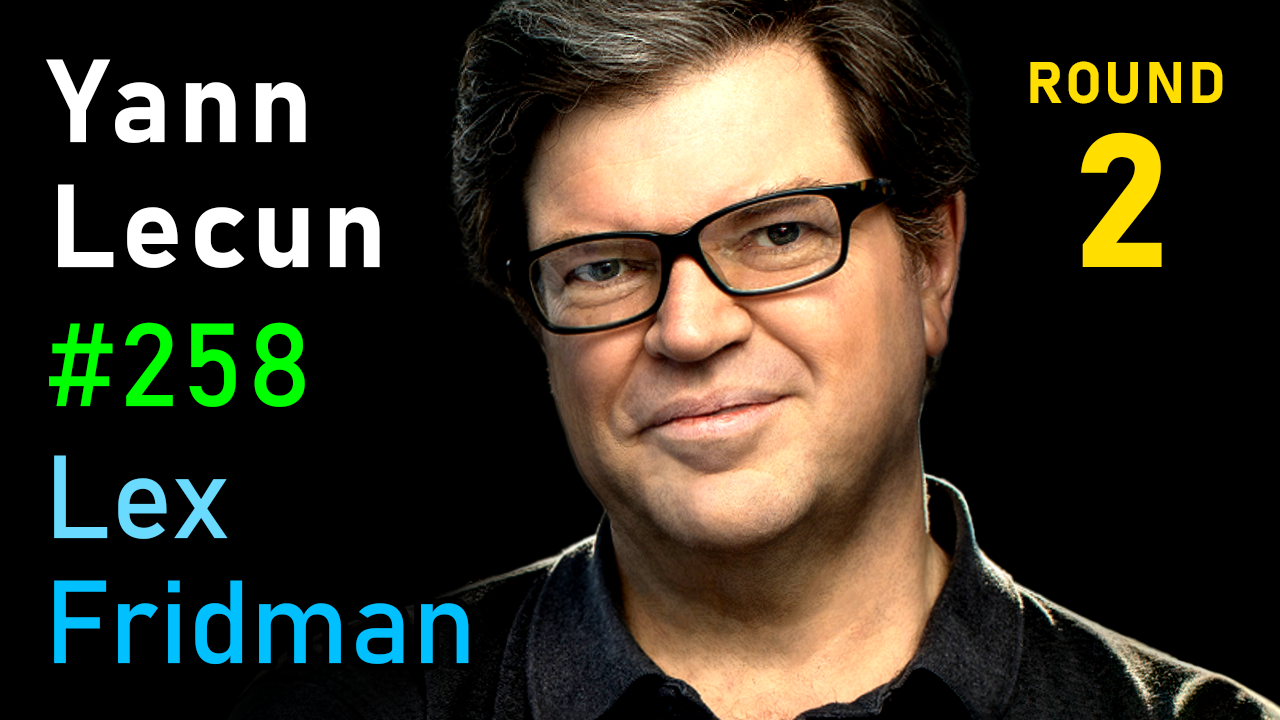
在本期播客中,Meta首席AI科学家杨立昆(Yann LeCun)与主持人Lex Fridman进行了其第二次深度对话,核心聚焦于“自监督学习”(Self-Supervised Learning)为何被视为“智能的暗物质”。杨立雄指出,当前主流的监督学习和强化学习在效率上存在根本缺陷,无法解释人类(尤其是儿童)和动物如何通过观察快速掌握关于世界的背景知识。他认为,自监督学习——即系统通过预测缺失信息(如视频下一帧或文本中的空白词)来学习——是构建“世界模型”、实现机器真正智能的最有希望的路径。这次对话涵盖了从基础学习原理到意识本质的广泛议题。

核心观点

  • 自监督学习是高效学习的关键:监督学习需要大量标注样本,强化学习需要海量试错。而自监督学习通过让模型预测数据中的缺失部分(如文本填空、视频预测),能从原始数据中获取远比前两者丰富的监督信号,这是人类和动物高效学习的基础。
  • “填补空白”是通用智能的潜在公式:无论是语言中的完形填空,还是视觉中预测视频的下一帧,这种“预测缺失信息”的框架可能是通向视觉和语言通用智能的最佳现有方法。它迫使模型学习关于世界如何运作的内部表征。
  • 从视频学习世界模型是当前最大挑战:自监督学习在语言领域(如GPT类模型)已非常成功,但在视觉领域,尤其是让模型仅通过观看视频来学习世界表征,尚未取得突破。这要求模型能处理连续、高维且不确定的预测问题。
  • 智能本质上是特定类型的统计:杨立昆认为,批评者称“这不过是统计而非智能”可能是正确的,但关键在于这是何种统计。智能模型必须能学习包含因果关系、能进行干预推理的深层机制模型,而不仅仅是表面的模式匹配。
  • 可微分的世界模型是未来十年核心目标:AI的下一个大挑战是让机器学习能够处理现实世界复杂性和不确定性(如人类行为、集体物理现象)的可微分世界模型。这与经典的模型预测控制原理相通,但模型需要从数据中自动学习而非手动设计。
  • 非对比式自监督学习前景更广:相比于需要大量负样本的对比学习(如SimCLR),杨立昆更看好基于最大化互信息的非对比方法(如VICReg),它通过正则化确保表征的多样性与不变性,是当前最令他兴奋的方向之一。
  • “具身智能”不可或缺:纯文本训练无法赋予机器真正的物理常识。例如,“推桌子时桌上的物体会一起移动”这类知识几乎不存在于文本中。智能需要从高带宽的感官观察(尤其是视觉)中学习,这是通向物理常识和现实AI的必经之路。

金句

  • "It's quite possible that intelligence is just statistics, it's just statistics of a particular kind." —— “智能很可能只是统计,但是一种特定类型的统计。”
  • "The essence of intelligence is the ability to predict, and everything the brain does is trying to predict everything from everything else." —— “智能的本质在于预测能力,大脑所做的一切都是试图用一切来预测一切。”
  • "The big challenge of AI for the next decade is how do we get machines to learn pretty accurate models of the world that deal with uncertainty and deal with the real world in all its complexity." —— “未来十年AI的重大挑战在于,如何让机器学习能够应对不确定性及现实世界所有复杂性的、相当精确的世界模型。”
  • "I believe in grounded intelligence. I don't think we can train a machine to be intelligent purely on text, because the amount of information about the world that's contained in text is tiny compared to what we need to know." —— “我坚信具身智能。我不认为仅靠文本就能训练出智能的机器,因为文本中包含的世界信息量与我们所需知道的相比微不足道。”
原文链接

查看完整访谈

完整内容见原文:Lex Fridman Podcast · Yann LeCun:智能的本质是统计,但必须是特定类型的统计