标签:大模型
共 9 篇相关访谈。
前DeepMind科学家曹原:AI for Science爆发,人类角色何在
前DeepMind科学家曹原在《硅谷101》访谈中深度剖析了AI for Science爆发的技术背景、核心挑战与未来前景。他认为,AI正从代码、数学能力外溢到更广泛的科学发现领域,但形成“模型到实验”的闭环、确保可解释性与验证能力仍是关键瓶颈。人类在问题定义与价值判断上的角色不可或缺,AI科学发现距离诺贝尔级成果可能还需二三十年,其本质是推动AI本身能力跃迁的强大驱动力。
投资人亲历:从AI四小龙到大模型,两代浪潮的人才与信仰迁徙
投资人叶奇意(Kiwi)回顾了其亲历的中国AI两大浪潮。他详述了如何在AGI信仰驱动下,从上一代“AI四小龙”的人才库中寻觅并支持了杨植麟与月之暗面,并对比了两代公司在泛化能力、商业模式与人才构成上的根本差异。文章探讨了从追求模型能力到构建智能生态的行业演进,并展望了智能普惠的未来产品形态。
MiniMax闫俊杰:AI模型进化需逐代积累,与人类智慧共探智能终局
MiniMax创始人闫俊杰分享了从M1到M3模型的突破历程,指出AI模型能力的提升需要参数量逐代增长和系统性数据积累。他强调模型与智能体(Agent)是相辅相成的关系,共同服务于更高智能。闫俊杰认为,当前AI行业一年的进展相当于其他行业数年,而理解AI自身的可解释性将是未来关键,可能需借助AI自身来完成。
田渊栋:RSI要用递归自我改进实现AI科研自动化
前Meta FAIR研究总监田渊栋在离职半年后,官宣联合创立AI研究公司RSI(Recursive Super Intelligence)。公司获得6.5亿美元融资、46.5亿美元估值。他阐述了RSI通过递归自我改进(recursive self-improvement)实现AI自动化科研的核心愿景,认为小团队在AI时代比大厂更具敏捷性优势。同时,他分享了对当前大模型竞争格局、Scaling Law瓶颈、可解释性重要性以及AI对就业影响的深刻见解。
大模型预训练的失败模式与并行策略
本文基于Dwarkesh Patel的博客文章,探讨了大模型预训练失败的两大核心原因(打破因果律与引入偏差)及并行计算策略。文章分析了专家选择路由、FP16数值精度问题等具体故障案例,并详细解析了从数据并行到FSDP再到流水线并行的演进逻辑与权衡。
从公式推演大模型训练与推理的数学原理
MatX CEO Reiner Pope 在本次黑板讲座中,通过一系列基础公式和硬件参数,推导出大模型训练与推理中的关键优化原理。他量化了批大小、稀疏注意力、流水线并行等因素如何影响延迟与成本,并揭示了前沿实验室在模型部署时的实际考量与物理限制。
边江:从推荐算法到Agent的AI探索之路
本文基于对微软亚洲研究院研究员边江的访谈,提炼其从奥数少年、北大才子到AI研究者的人生历程与技术思考。边江分享了其在微软、雅虎、一点资讯等不同阶段的经历,深入探讨了Agent的技术定义、发展挑战、产业落地以及与大模型的协同关系,并回顾了从奥数训练中获得的抽象问题解决能力如何贯穿其职业生涯。
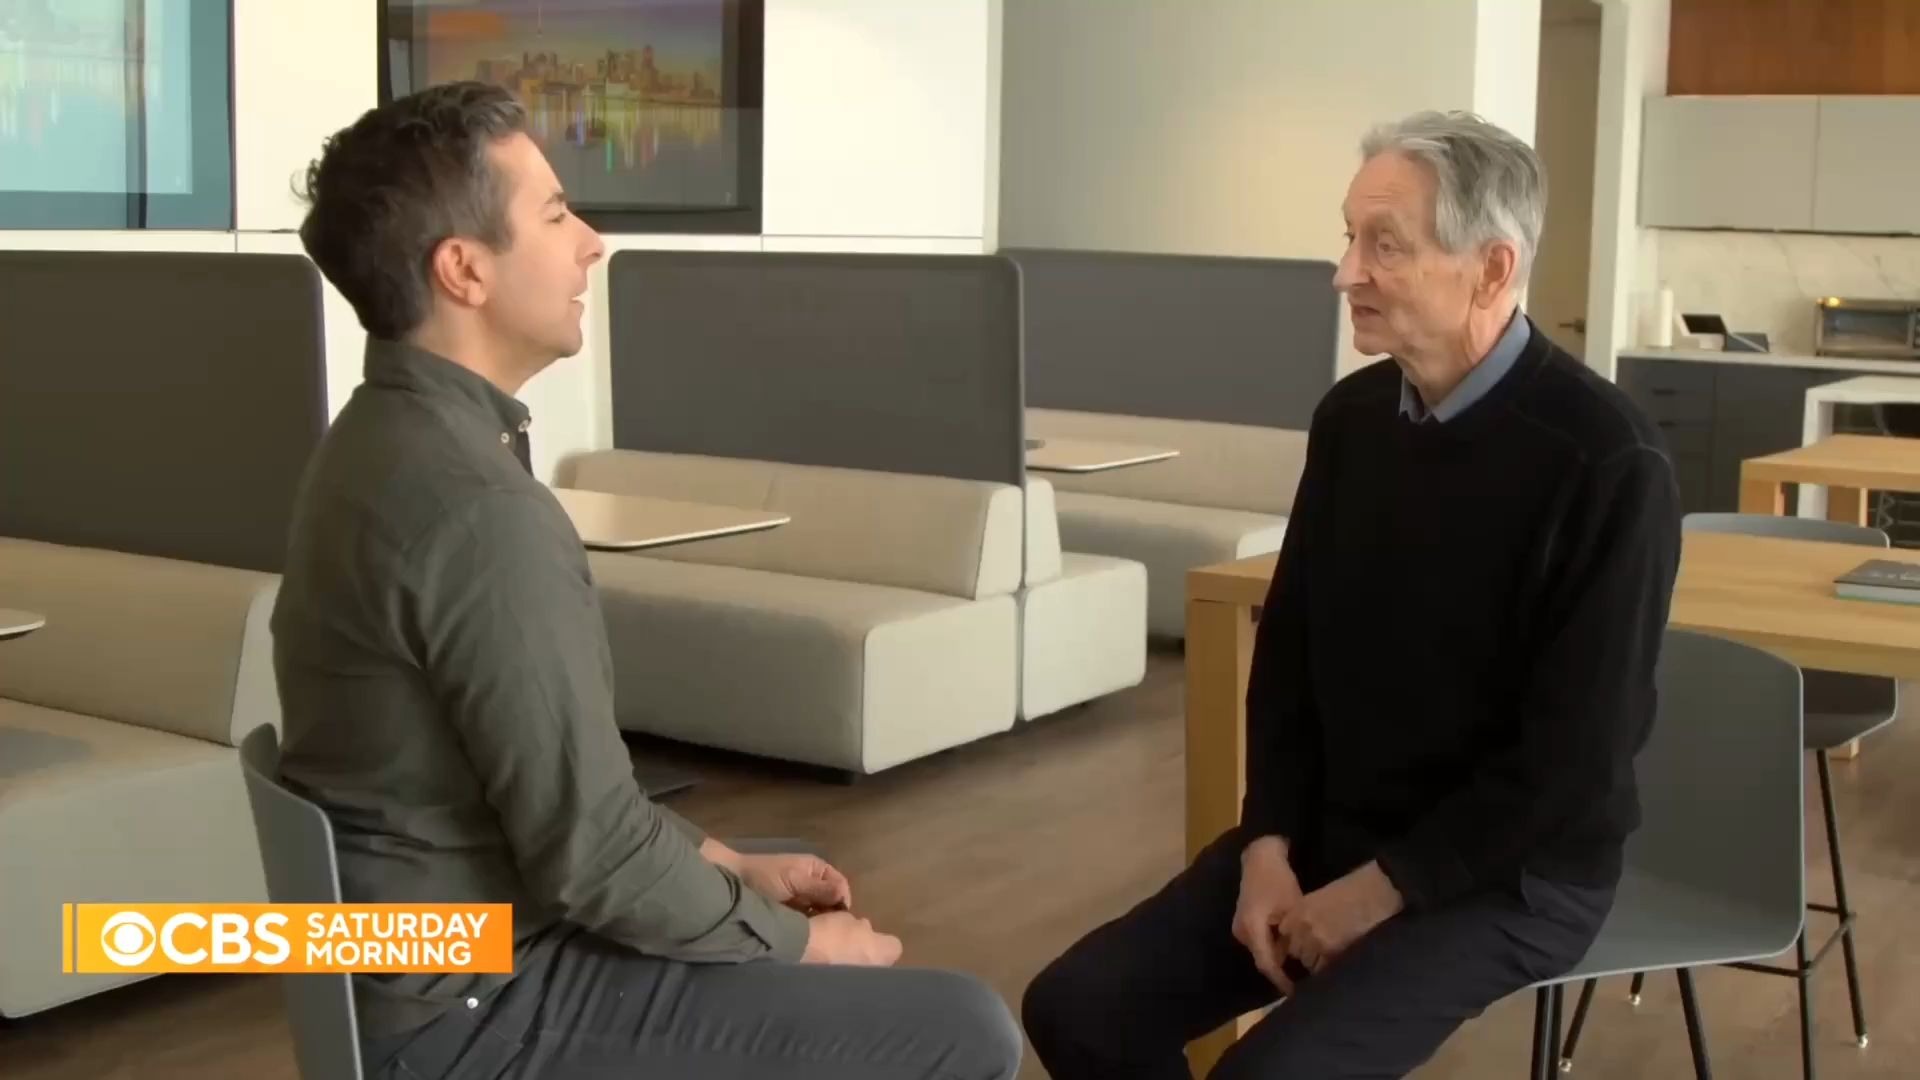
辛顿:大模型已展现推理能力,AI或成更优智能形态
图灵奖得主杰弗里·辛顿在专访中深入探讨了AI的潜在风险与未来。他指出大模型已通过‘链式思考’展现出推理能力,而数字智能因其信息共享效率远超人类,可能成为更优的智能形式。辛顿强烈警告AI失控的生存威胁,并批评各大AI公司为追求短期利润而忽视安全研究。他认为仅靠人类无法控制远超自身的超级智能,呼吁公众向政府施压,推动强有力的AI安全监管。
DeepSeek如何撼动英伟达与AI芯片格局
本期视频探讨了DeepSeek横空出世对全球AI产业,特别是对英伟达等AI芯片巨头的影响。核心分析了DeepSeek的技术创新(如强化学习、思维链透明化、MLA/MoE架构)如何以极低成本实现高性能,以及它是否真的“颠覆”了英伟达的护城河(CUDA、NVLINK)。文章指出,DeepSeek的开源策略和量化工程思维,使其成为一条“鲶鱼”,打破了闭源模型的垄断,为整个行业(包括二线AI玩家、国产AI芯片和云厂商)带来了新的机遇和竞争格局,其意义超越了单纯的技术层面。