AI下半场:强化学习如何驱动Agent蜂群进化

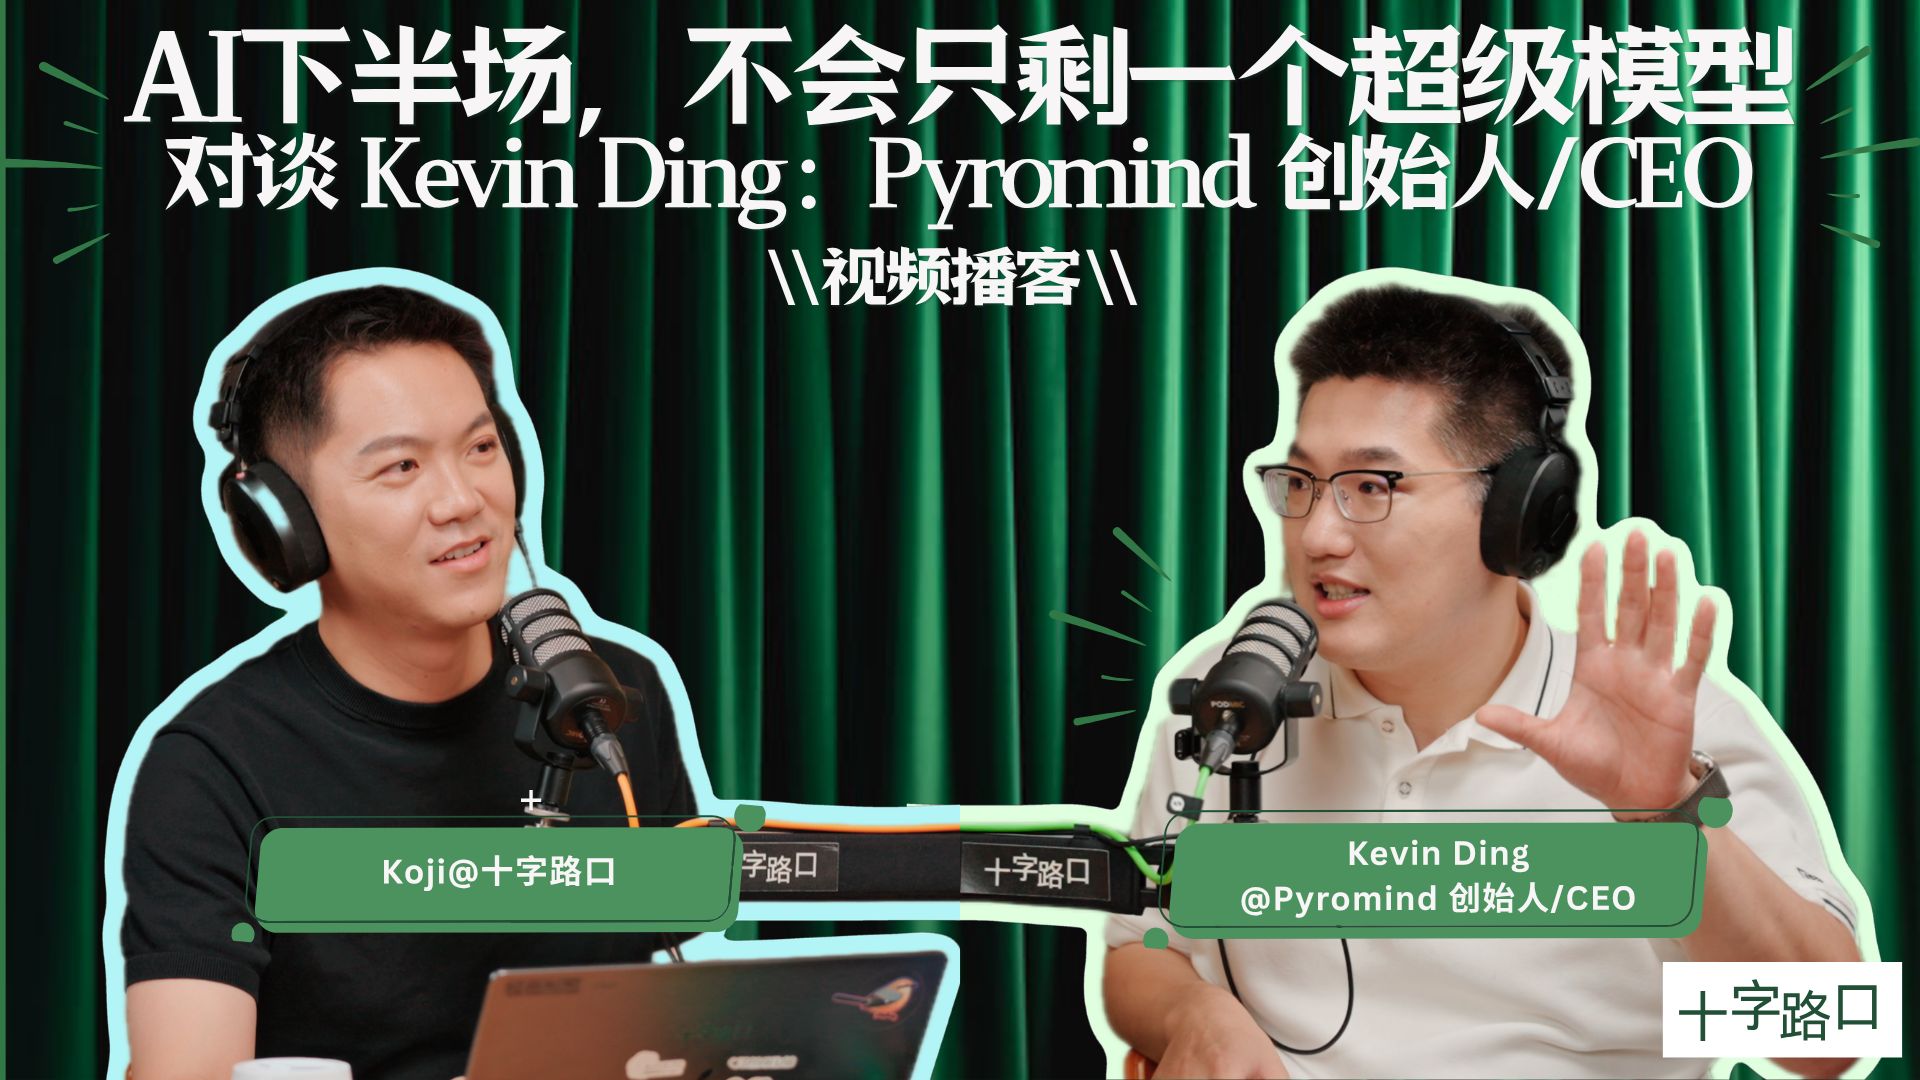
Pyromind创始人Kevin Ding在访谈中阐述了AI进入下半场的核心逻辑:从追求单一超级模型转向服务化的Agent蜂群。他提出通过Auto RL实现强化学习即服务(RLS)是落地关键,并分享了Pyromind如何聚焦工业质检、工艺优化等垂直场景,通过构建可复用的奖励结构,解决企业效率、成本与隐私的‘不可能三角’,从而跑通商业闭环。

丁轶

导语

在AI从“预训练”主导的上半场迈向应用落地的下半场之际,行业正面临路线之争:是继续追逐一个全能的中央化超级模型,还是发展分布式的、服务化的Agent蜂群?Pyromind创始人兼CEO Kevin Ding(丁轶)明确站队后者。他在本篇访谈中详细阐述了为何强化学习即服务(RLS)是实现这一愿景的关键路径,并介绍了其公司如何通过Auto RL平台,在工业质检、工艺优化等垂直场景中验证商业可行性,同时通过其开源的Paradise架构,探索解决企业在AI落地中面临的成本、效率与隐私的“不可能三角”难题。
大纲与深读 6 章

展开「深读」看每一段讨论的问题与论据。

01

创业背景与核心定位

00:01
  • 创始人Kevin有阿里云弹性GPU集群经验,创立PROMIND旨在探索AI下半场的服务化形态
  • PROMIND定位为Auto RL,是RSI(强化学习服务)的具象化实现路径
  • 公司完成天使轮融资,投资方包括高瓴、百度风投、蓝驰等,团队20余人
深读这一段

讨论的问题:为什么选择从AI基础设施转向提供强化学习服务?

论据 / 案例:团队20多人,已跑通PMF,证明Auto RL在生产环境有价值且可横向扩展。

02

技术理念与演进逻辑

00:05
  • 认为AI下半场将走向服务化、Agent蜂群形态,而非单一中心化超级模型
  • 服务化趋势下,Agent数量激增,其自我迭代改进的需求催生了RSI
  • 从提供训练基础设施(Studio)演进到自动化闭环优化(EchoMind)
  • 核心产品逻辑:用户代理URL接入后,自动抓取轨迹、生成奖励、训练并部署
深读这一段

讨论的问题:从提供RL-as-a-Service到推动Auto RL,是基于怎样的观察和判断?

论据 / 案例:以GUI Agent客户为例,最初提供Studio仍需客户投入人力维护Agent,后通过EchoMind实现自动化数据回流与模型更新循环。

03

工业场景落地与价值验证

00:10
  • 典型客户画像:工业领域(如英伟达上游企业),数据富集且有明确好坏标签
  • 重点场景:工艺优化(如电镀参数配置)与质检(可见光/结构光质检)
  • 工业场景优势:数据丰富、评价基准明确、ROI可衡量
深读这一段

讨论的问题:如何选择和切入适合Auto RL落地的垂直场景?

论据 / 案例:在质检场景,通过约1万张样本训练,可将误报率从23%显著降至8%,成本收益清晰。

04

商业模式与定价体系

00:20
  • 分层产品:Studio(自助式训练服务)按资源单元计费;EchoMind(Auto RL产品)按场景价值计费
  • 资源单元定义:单轮Auto RL训练成本,与Token无直接绑定,包含奖励价值溢价
  • 客户ROI计算:主要基于场景价值提升,而非单纯模型调用成本
深读这一段

讨论的问题:如何设计一种能清晰反映价值创造的定价模式?

论据 / 案例:单体B端客户付费区间可达百万至千万人民币,价格取决于Agent创造的效益。

05

动态奖励模型与技术架构

00:30
  • 奖励模型需从生产环境数据中解耦,实现无状态化以支持横向扩展
  • 奖励信号来源:模型rollout的advantage评估,或包含人工判断的回流数据集
  • 奖励结构需跨领域适配,但在相似模态上可部分复用
深读这一段

讨论的问题:如何构建一个既能服务生产环境又可通用化的奖励模型体系?

论据 / 案例:PARADISH开源工作提供正确性、成本奖励及隐私掩码模型工具,验证了协作式推力引擎架构。

06

竞争格局与差异化壁垒

00:40
  • 行业分化路线:纵向全场景服务化(如Applied Computer) vs 横向专注训练环节(如Trajectory)
  • PROMIND选择横向扩展路径,聚焦无状态Auto RL管道
  • 壁垒:深入垂直场景的奖励工程能力、与业务数据的适配经验
深读这一段

讨论的问题:面对云厂商和同类技术公司的潜在竞争,如何构建护城河?

论据 / 案例:云厂商目标广泛,难以实现PROMIND式的敏捷与专用;当前在选定工业领域竞争较少。

金句

  • "AI下半场将是一个服务化的形态,是一个Agent的蜂群的形态。"
  • "Auto RL的这个管道以及reward本身,它其实就是一个无状态的,它跟那个生产上下文其实是不耦合的。"
  • "HARNESS词他给提供的更多的是一些流程性的东西...你如果说不去修改这个模型,它不去训练它,它可能模型能够解决的这个问题就相对来说比较有限。"
  • "不同的视角进来,这就都是自带奖励信号的,然后你这种多目标的奖励信号下提炼出来这个结果,他有可能就离真相很近了。"

原文链接

查看完整访谈

完整内容见原文:Koji杨远骋at十字路口 · AI下半场:强化学习如何驱动Agent蜂群进化