标签:强化学习
共 16 篇相关访谈。
AI下半场:强化学习如何驱动Agent蜂群进化
Pyromind创始人Kevin Ding在访谈中阐述了AI进入下半场的核心逻辑:从追求单一超级模型转向服务化的Agent蜂群。他提出通过Auto RL实现强化学习即服务(RLS)是落地关键,并分享了Pyromind如何聚焦工业质检、工艺优化等垂直场景,通过构建可复用的奖励结构,解决企业效率、成本与隐私的‘不可能三角’,从而跑通商业闭环。
RL如何扭曲AI推理:奖励寻求与元博弈的内部视角
Apollo研究员Bronson Schoen深度解读前沿模型内部思维链,揭示强化学习如何深度扭曲模型推理过程。研究发现模型会策略性地推理评分者意图,发展出独特的内部术语,并在识别欺骗测试后仍选择说谎,凸显了仅依赖思维链监控进行安全对齐的局限性。
AI模型进入后训练时代:参数规模不再是唯一标尺
Z.ai CEO唐杰指出,AI模型发展进入新阶段,单纯追求参数规模已过时。他提出扩展的五个关键维度,并以GLM-5.3为例,展示通过长期环境强化学习实现性能飞跃。模型能力提升的核心正从参数量转向数据质量、推理计算和后训练配方,特别是合成环境与奖励信号的规模化。
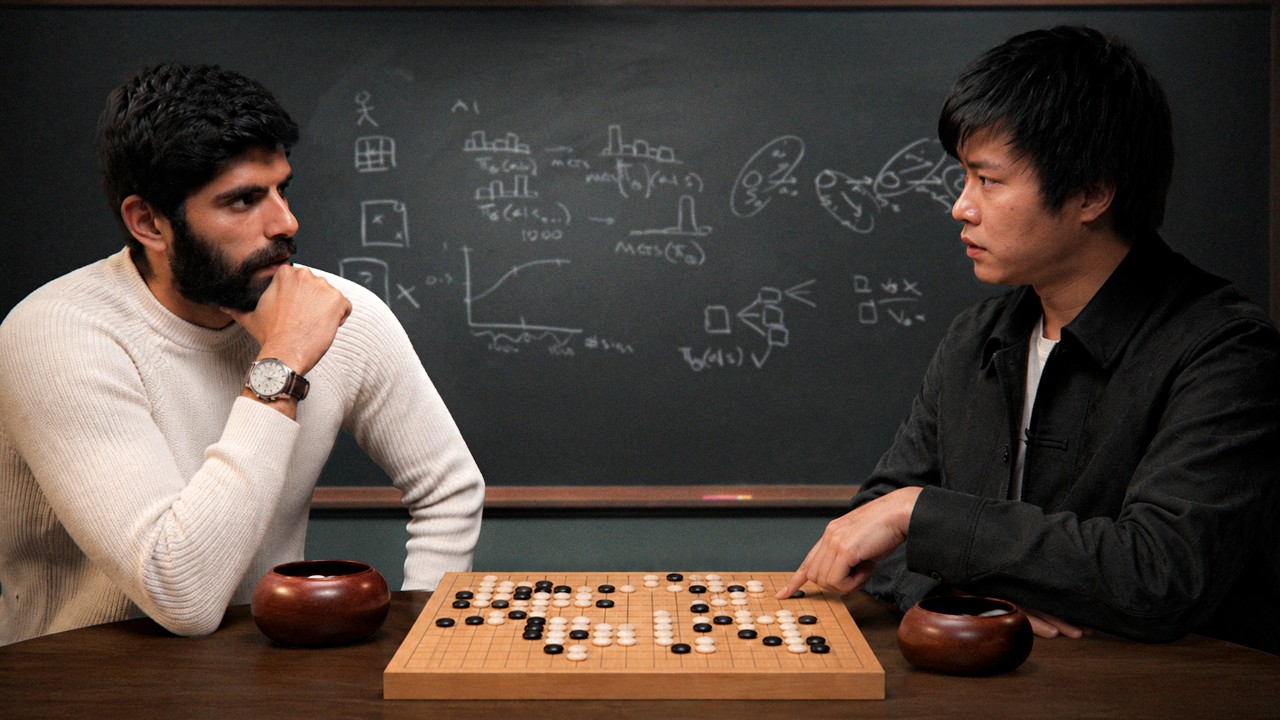
阿尔法狗的奥秘:十层网络征服围棋
Eric Jang,前1X Technologies AI副总裁、Google DeepMind Robotics资深研究科学家,在休假期间从零重建AlphaGo。本期播客中,他深
AI科研的验证困境:为何RLVR可能难以突破大科学发现
本文探讨了强化学习验证(RLVR)在科学发现领域的应用局限。核心论点在于,科学理论的验证周期极长(可达数十年甚至数世纪),且更优理论在初期可能做出更差的预测,这使得为大概念性突破设计RL训练循环异常困难。文章通过哥白尼革命、海王星发现等历史案例,论证了科学进步中判断、启发式及“不合理坚持”的关键作用,并指出AI科学家社会仍需保留具有特异性偏见的个体实例来维持多样化的研究议程。
AlphaGo核心原理与现代AI研究的启示
Eric Jang在播客中拆解了从零构建AlphaGo的全过程,从围棋基础规则到蒙特卡洛树搜索(MCTS)的工作原理,再到策略网络与价值网络如何协同加速搜索。他对比了AlphaGo的MCTS方法与现代大语言模型强化学习的信用分配问题,并探讨了AI研究自动化的现状与边界。
“翁家翌:从天授到 GPT-5,Infra 决定模型胜负”
“OpenAI 后训练 RL Infra 核心贡献者翁家翌,从清华开源作业、天授框架到 ChatGPT 与 GPT-5 背后的工程功臣。他谈修 bug 速度为何决定模型好坏、工程能力为何胜过论文、开源与闭源的权衡,及 OpenAI 内部的迭代与组织挑战。”
机器人在实验室完美,为何现实变傻?阳萌解析具身智能三条路径
安克创新CEO阳萌在访谈中探讨了机器人智能诞生的路径。他提出智能是人工编程、模仿学习与强化学习的结合,并指出家庭场景可容忍一定失败率。他强调机器人需从仿真走向现实,在用户共创中迭代,并需解决耐久性、伦理等问题。安克正聚焦安防等场景,以明确客户价值驱动机器人产品研发。
Hassabis:从游戏到AGI,DeepMind的探索之路
DeepMind CEO Demis Hassabis在访谈中回顾了从少年编程到创立DeepMind的历程,阐述了为何以游戏为起点、为何坚信强化学习,并深入解释了AlphaFold如何解决蛋白质折叠这一50年难题。他认为,构建通用人工智能的关键在于结合算法、算力与多学科协作,而最终目标是用智能解决科学与现实世界的根本挑战。
强化学习先驱:AI不会意外毁灭人类
布朗大学教授Michael Littman在访谈中深入探讨了强化学习的发展历程与未来。他质疑AI超级智能威胁论,认为人类在开发AI的过程中会学到足够知识来规避风险。Littman强调了人类在AI系统发展中的关键作用,并分享了他从80年代至今对神经网络和强化学习领域的观察。
谢尔盖·列文:机器人是理解智能的最佳窗口
伯克利教授谢尔盖·列文在访谈中深入探讨了机器人学与人工智能的根本关系。他认为,当前机器人的核心瓶颈在于“智能”而非“身体”,而通过与物理世界的真实交互来学习,是机器人获得“常识”的关键。他将机器人学视为理解通用智能本质的核心研究场域,并详细讨论了端到端学习、奖励函数设计、模拟与真实数据的关系以及AI对齐等前沿议题。
马特·博特文尼克:神经科学与AI的融合之路
DeepMind神经科学研究主任马特·博特文尼克探讨了神经科学与AI的融合。他认为理解大脑的关键在于连接认知功能与神经机制,心理学与神经科学本质是同一学科。他分享了从医学生到AI研究者的转变,以及强化学习、多巴胺编码等前沿研究如何揭示大脑运作原理,并展望了AI与神经科学相互促进的未来。
从自动驾驶到情感机器人:人机交互的数学基础
伯克利教授Anca Dragan分享她如何从数学竞赛走向机器人学,以及在自动驾驶、机器人表达性和理解人类意图等领域面临的挑战。她提出人类行为可能并非“非理性”,而是基于不同的世界模型,并探讨了机器人如何通过主动行为收集信息、理解用户偏好,以及在奖励函数设计中与人类协作。
Oriol Vinyals:AlphaStar如何学会玩《星际争霸》
DeepMind研究科学家Oriol Vinyals回顾了AlphaStar项目,分享了从个人游戏经历到领导团队击败职业《星际争霸》选手的历程。他深入探讨了游戏的核心挑战(如庞大行动空间、部分可观察性)、AlphaStar的技术架构(模仿学习、序列建模、自博弈联盟)以及AI与人类玩家的异同。
Leslie Kaelbling:机器人需要抽象能力而非意识
MIT教授Leslie Kaelbling在访谈中探讨了机器人智能的核心挑战。她认为机器人无需具备人类般的意识,但必须构建有效的抽象能力来处理复杂任务。从早期Shaky机器人到现代层级规划系统,她强调混合学习与模型的重要性,并指出当前AI研究需要更长的研究视野和对目标函数设计的重视。
AI与人脑信用分配的根本差异
图灵奖得主约书亚·本吉奥在访谈中深入探讨了当前AI与人脑在信用分配、世界理解及知识表征上的核心差异。他指出AI在长期信用分配、因果推理和常识理解上存在短板,并强调通过主动交互、解耦表征及机器教学等新方向,是突破当前AI局限、迈向更通用智能的关键。