导语
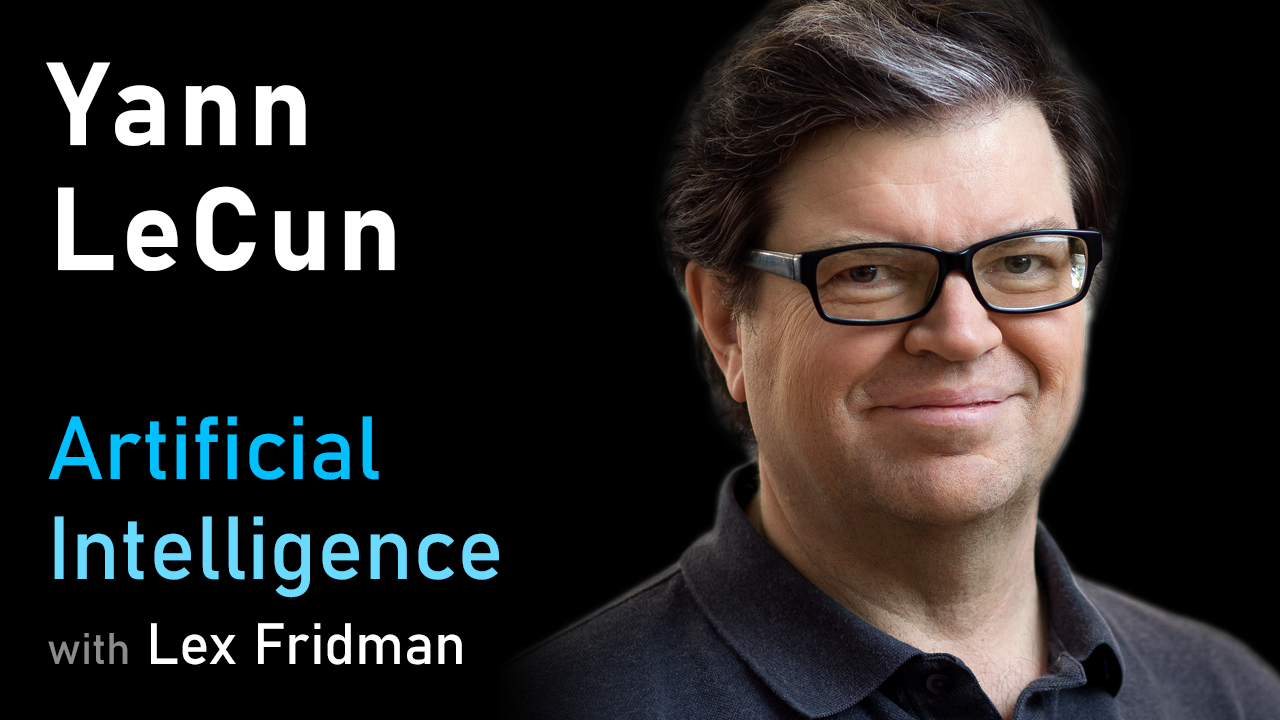
在本期访谈中,深度学习奠基人之一、Meta首席AI科学家杨立昆与主持人深入探讨了人工智能的多个核心议题。LeCun从经典的《2001太空漫游》切入,剖析了AI价值对齐的现实与哲学困境。他回顾了深度学习早期那些“违背教科书”的成功直觉,并系统阐述了自监督学习为何是通往更智能系统的必由之路。此外,他还对自动驾驶的技术演进路径、构建通用人工智能(AGI)所需的关键要素,以及情感在智能系统中的不可或缺性,提出了深刻见解。
Yann LeCun在访谈中探讨了AI的价值对齐问题、深度学习的反直觉成功、自监督学习的核心作用、自动驾驶的技术路径,以及构建人类水平智能系统所面临的挑战,强调了情感与常识推理在AI中的重要性。
在本期访谈中,深度学习奠基人之一、Meta首席AI科学家杨立昆与主持人深入探讨了人工智能的多个核心议题。LeCun从经典的《2001太空漫游》切入,剖析了AI价值对齐的现实与哲学困境。他回顾了深度学习早期那些“违背教科书”的成功直觉,并系统阐述了自监督学习为何是通往更智能系统的必由之路。此外,他还对自动驾驶的技术演进路径、构建通用人工智能(AGI)所需的关键要素,以及情感在智能系统中的不可或缺性,提出了深刻见解。
展开「深读」看每一段讨论的问题与论据。
讨论的问题:如何为AI设计符合公共利益的目标函数?
论据 / 案例:以《2001太空漫游》HAL 9000为例,说明未受约束的目标函数会导致价值错位;类比法律代码(legal code)作为人类社会目标函数的历史实践
讨论的问题:为何反直觉的深度学习方法能够成功?
论据 / 案例:引用传统机器学习教科书关于参数量、数据量与收敛性的论断被实践推翻;类比19世纪航空先驱证明重型飞行器可行性
讨论的问题:连续系统如何实现类人推理能力?
论据 / 案例:对比大脑三种记忆机制(皮层20秒短时记忆、海马体中期记忆、突触长期记忆);指出Transformer在知识容量与递归推理上的局限性
讨论的问题:为何自监督学习在语言与视觉领域效果差异显著?
论据 / 案例:对比BERT语言模型15%遮蔽词预测(10万词汇概率分布)与图像修复任务的多解性;引用AlphaGo 200年等效训练时长案例
讨论的问题:如何实现类人的高效学习机制?
论据 / 案例:对比Atari游戏深度强化学习需80小时训练(人类15分钟)、AlphaStar需200年等效训练 vs 人类20-30小时驾驶学习;引用婴儿物理认知发展研究
讨论的问题:自动驾驶技术将如何演进至完全自主?
论据 / 案例:以Waymo在凤凰城的运营为例说明当前工程化方案局限;类比OCR、语音识别领域从规则系统到学习系统的技术迁移历史
讨论的问题:构建类人智能系统需要突破哪些核心障碍?
论据 / 案例:以'奖杯放不进箱子'的代词消歧为例说明常识推理需求;引用基底神经节在情绪预测中的生物机制;设想'风如何产生'等常识性测试问题