标签:训练
共 3 篇相关访谈。
AI进化的下一步:从训练到“做梦”
在本期播客中,Dwarkesh Patel深入探讨了当前AI实验室的核心赌注——通过RLVR(强化学习+可验证奖励)训练生成通用智能体。他提出,尽管这一路径已取得显著进展,但AI在
D德瓦克什·帕特尔Dwarkesh Podcast 嘉宾
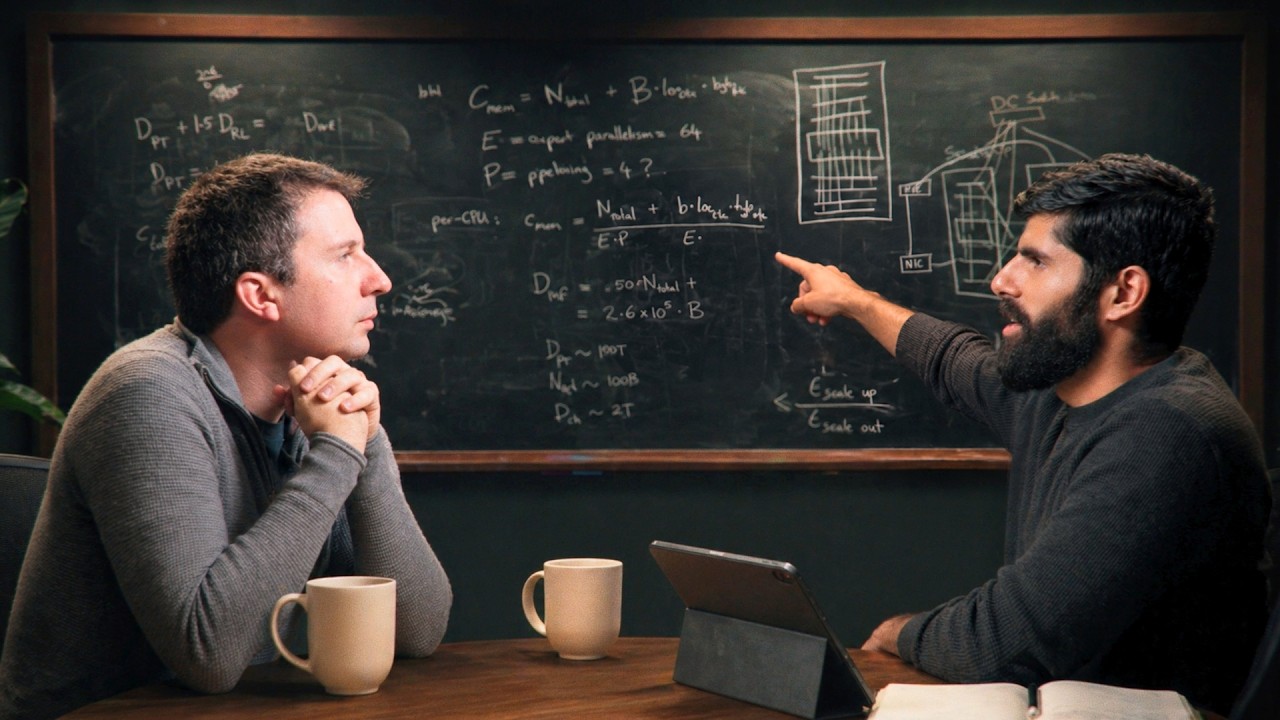
推理成本真相:批处理决定AI定价
本期嘉宾Reiner Pope是芯片初创公司Maddox的CEO,曾在谷歌从事TPU架构等工作。在这期黑板讲座形式的访谈中,他系统拆解了大模型推理的底层物理规律——从批处理大小如何
R赖纳·波普Dwarkesh Podcast 嘉宾
R
从公式推演大模型训练与推理的数学原理
MatX CEO Reiner Pope 在本次黑板讲座中,通过一系列基础公式和硬件参数,推导出大模型训练与推理中的关键优化原理。他量化了批大小、稀疏注意力、流水线并行等因素如何影响延迟与成本,并揭示了前沿实验室在模型部署时的实际考量与物理限制。
RReiner PopeCEO of MatX, 前Google TPU架构师