推理成本真相:批处理决定AI定价

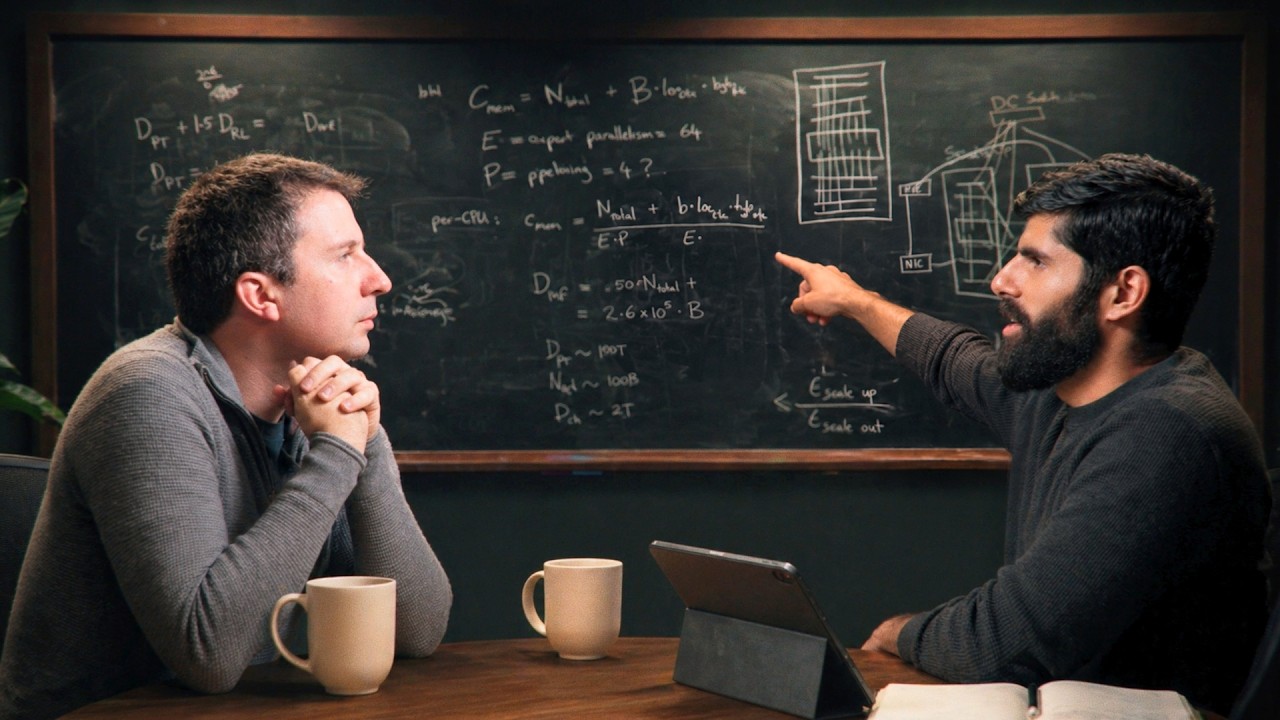
本期嘉宾Reiner Pope是芯片初创公司Maddox的CEO,曾在谷歌从事TPU架构等工作。在这期黑板讲座形式的访谈中,他系统拆解了大模型推理的底层物理规律——从批处理大小如何

赖纳·波普

导语

本期嘉宾Reiner Pope是芯片初创公司Maddox的CEO,曾在谷歌从事TPU架构等工作。在这期黑板讲座形式的访谈中,他系统拆解了大模型推理的底层物理规律——从批处理大小如何决定延迟与成本,到内存带宽如何限制上下文长度,再到稀疏专家模型与集群通信的权衡,解释了API价格、模型规模演进乃至AI进步速度背后的硬约束。

核心观点

  • 批处理大小是推理成本与延迟的核心变量。若不进行批处理,单用户推理的经济性会比批处理差约千倍;而批处理大小的最优值约等于300乘以模型稀疏度,与模型绝对规模无关,实践中通常取该值的2-3倍。
  • 单次推理存在延迟下限,由硬件决定:必须将全部模型权重从内存读入芯片,这一内存搬运时间无法绕过。典型GPU集群的HBM容量除以带宽约为15-20毫秒,即“一班列车”的出发间隔。
  • 稀疏专家模型(如DeepSeek)能大幅降低计算量,但会增加内存容量需求与通信开销。经验数据显示,将总参数扩大64倍仅能等效于4倍活跃参数的模型质量提升,因此稀疏化并非免费午餐。
  • GPU集群的物理布局——特别是机架内的高速互联与机架间的低速网络——决定了模型架构的可扩展性。专家并行需全对全通信,强烈依赖机架内高速网络;而流水线并行则天然适合跨机架扩展。
  • 当前最大推理和训练集群的规模受限于机架内的“scale-up”域大小。从Hopper的8卡到Blackwell的72卡,再到Rubin的500+卡,机架内互联带宽的提升是模型规模能够继续增长的物理前提。
  • 流水线并行只能分摊模型权重的内存占用,却无法分摊KV缓存的内存需求。因为KV缓存随批处理大小线性增长,与流水线深度无关,这使得推理场景中KV缓存成为内存瓶颈。
  • 从成本均衡角度倒推,前沿模型(如GPT-5)的推理token总量、预训练token总量和RL训练token总量应大致相等。据此估算,当前模型预训练数据量约为200万亿token,是Chinchilla最优值的100倍——本质上是为降低推理成本而“过度训练”。
  • 从API定价可反推模型内部参数:Gemini 3.1在200K上下文处价格上涨50%,对应着内存带宽与计算吞吐均衡点;输入输出价格5倍差表明decode阶段严重受内存带宽限制;而缓存写入与读取的价格差则揭示了HBM、DDR、闪存、机械硬盘这四级内存层级的使用策略。
  • 长上下文扩展的瓶颈不在计算而在内存带宽。近两年上下文长度停滞在100K-200K左右,正是因为跨越这一平衡点后内存成本急剧上升,而稀疏注意力虽能改善但会牺牲模型质量。

金句

  • "The big effect is batch size but what we're going to do now is quantify exactly what that looks like and what its implications are on latency and cost." —— 最大的影响因素是批处理规模,接下来我们要精确量化它对延迟和成本的影响。
  • "Pipelining totally solves the capacity problem, but scale up size helps solve the bandwidth problem." —— 流水线并行完全解决了容量问题,但扩大机架内互联规模才能解决带宽问题。
  • "I think it's like if you look at the history of context lengths of models... they shot up from about 8K to 100K 200K and then for the last year or two they've all been hovering around there. I think that actually indicates that that's sort of the reasonably balanced cost point." —— 上下文长度从8K跃升至200K后便停滞不前,这恰恰说明那里是成本平衡点。
本内容由 AI 根据访谈字幕提炼,观点归嘉宾所有。

完整内容见原文:Dwarkesh Podcast · 推理成本真相:批处理决定AI定价