赖纳·波普
立场时间线 23 条 · 23 个议题
同一议题按时间排列,说法变化一目了然。
实验室算力年增仅3倍却需支撑收入10倍增长,只能靠利润率提升、算力涨价或推理算力占比上升三条途径,且三者目前均在发生。
“实验室算力年增仅3倍,为支撑收入10倍增长,只能依赖利润率提升、算力涨价或推理算力占比上升三途径,目前三者均在发生。”
来源访谈 →若人类级软件工程师能在单张H100同级算力上运行,按当前薪资水平该卡年租金应超25万美元,即现价15倍以上。
“若人类级软件工程师能跑在H100上,按当前薪资水平,该卡年租金应超25万美元。(英文原话:If a true human-level software engineer could run on an H100 equivalent, then at today's prices for software engineers, that H100 should rent for over 250k a year.)”
来源访谈 →智能存在强大的规模经济效应,担忧这将导致权力集中,但认为现实确实如此、难以回避。
“我宁愿我们生活的世界不存在如此强大的智能规模效应,因为我担忧权力集中,但现实似乎如此。(英文原话:I wish we didn't live in a world with such strong economies of scale for intelligence because I'm worried about power concentration, but it seems we do.)”
来源访谈 →算力成本通胀已经启动:谷歌以现货价2倍的单价月付9亿美元向SpaceX租用11万张GPU,现货价也比2月低谷高出40%。
“谷歌向SpaceX租用11万张GB200/GB300 GPU,月付9亿美元,单价达现货价2倍,而现货价已比2月低谷高40%,算力成本通胀已启动。”
来源访谈 →算力供给弹性极低,年度3倍增长中靠挤占手机PC晶圆份额贡献的1.8倍明年将触顶。
“算力供给弹性极低:年度3倍增长中,1.4倍来自摩尔定律、1.2倍来自新晶圆厂、1.8倍来自挤占手机PC晶圆份额,后者明年将触顶。”
来源访谈 →顶级实验室因能更高效变现算力,将在资源竞标中碾压对手,形成强者愈强的马太效应,小玩家生存空间急剧收窄。
“顶级实验室因能更高效变现算力,将在资源竞标中碾压对手,形成强者愈强的马太效应,小玩家生存空间急剧收窄。”
来源访谈 →批处理规模是决定推理成本与延迟的最大变量,最优批大小约等于300乘以模型稀疏度,与模型绝对规模无关。
“若不进行批处理,单用户推理的经济性会比批处理差约千倍;而批处理大小的最优值约等于300乘以模型稀疏度,与模型绝对规模无关,实践中通常取该值的2-3倍。”
来源访谈 →单次推理存在由硬件决定的延迟下限,因为必须把全部模型权重从内存读入芯片,这一时间无法绕过。
“单次推理存在延迟下限,由硬件决定:必须将全部模型权重从内存读入芯片,这一内存搬运时间无法绕过。典型GPU集群的HBM容量除以带宽约为15-20毫秒。”
来源访谈 →稀疏专家模型虽能大幅降低计算量,但增加内存容量与通信开销,扩大64倍总参数仅等效于4倍活跃参数的质量提升,并非免费午餐。
“经验数据显示,将总参数扩大64倍仅能等效于4倍活跃参数的模型质量提升,因此稀疏化并非免费午餐。”
来源访谈 →流水线并行只能解决模型权重的容量问题,带宽问题必须靠扩大机架内scale-up互联规模来解决。
“Pipelining totally solves the capacity problem, but scale up size helps solve the bandwidth problem. —— 流水线并行完全解决了容量问题,但扩大机架内互联规模才能解决带宽问题。”
来源访谈 →当前最大推理与训练集群的规模受限于机架内scale-up域大小,机架内互联带宽的提升是模型规模继续增长的物理前提。
“从Hopper的8卡到Blackwell的72卡,再到Rubin的500+卡,机架内互联带宽的提升是模型规模能够继续增长的物理前提。”
来源访谈 →流水线并行只能分摊权重内存而无法分摊KV缓存,后者随批大小线性增长,因此成为推理场景的内存瓶颈。
“流水线并行只能分摊模型权重的内存占用,却无法分摊KV缓存的内存需求。因为KV缓存随批处理大小线性增长,与流水线深度无关,这使得推理场景中KV缓存成为内存瓶颈。”
来源访谈 →当前模型预训练数据约200万亿token,是Chinchilla最优值的100倍,本质是为降低推理成本而刻意过度训练。
“据此估算,当前模型预训练数据量约为200万亿token,是Chinchilla最优值的100倍——本质上是为降低推理成本而“过度训练”。”
来源访谈 →模型上下文长度在100K-200K停滞一两年,说明这正是内存带宽与计算的合理成本平衡点,瓶颈不在算力。
“I think it's like if you look at the history of context lengths of models... they shot up from about 8K to 100K 200K and then for the last year or two they've all been hovering around there. I think that actually indicates that that's sort of the reasonably balanced cost point. —— 上下文长度从8K跃升至200K后便停”
来源访谈 →Reiner Pope认为低精度算术在神经网络中如此成功的唯一原因,是乘加电路规模随位宽呈简单的二次方关系,累加需要更高精度应对误差累积
“This is the single reason low-precision arithmetic has worked so well for neural nets.——这是低精度算术在神经网络上如此有效的唯一原因。”
来源访谈 →他认为在芯片设计中,与实际计算逻辑相比,几乎所有成本都是同步或通信成本,读取数据的多路选择器电路开销远超乘加运算本身
“Almost all your cost becomes synchronization or communication cost compared to the actual logic.——与实际逻辑相比,你几乎所有的成本都变成了同步或通信成本。”
来源访谈 →他认为GPU本质上是许多微型TPU的集合,每个SM都类似一个包含小型矩阵单元和向量单元的微型TPU,而TPU则采用少数大型矩阵单元的粗粒度设计
“A GPU is just a bunch of tiny TPUs.——GPU本质上就是一堆微型TPU。”
来源访谈 →他认为芯片设计的核心目标是把计算单元做大、同时保持数据移动单元规模不变,更大的计算单元能更好地分摊外围电路成本
“Make this one bigger somehow while keeping this at the same size. That's the goal.——想办法把这个(计算单元)做大,同时保持那个(数据移动单元)不变。这就是目标。”
来源访谈 →他指出插入流水线寄存器提高时钟频率存在经典权衡,因为吞吐量是每时钟周期完成的工作量与每秒时钟数的乘积,提频可能反而损害吞吐量
“It hurts your throughput, in fact, because the throughput of your chip is the product of how much you get done per clock cycle... times how many clocks you get per second.——它实际上损害了你的吞吐量,因为芯片的吞吐量是每个时钟周期完成的工作量乘以每秒的时钟数。”
来源访谈 →专家层的可行规模由单个GPU机架的物理边界决定:机架内高速互连可支撑All-to-All通信,跨机架的低速互连会成为瓶颈。
“一个机架(的物理规模)限制了你能运行的专家层的大小。(英文原话:One rack bounds the size of an expert layer you can do.)”
来源访谈 →硬件切分方式与模型架构天然匹配,并行策略应由物理拓扑直接塑造:专家并行利用机架内互连,流水线并行将不同层分布到不同机架。
“(硬件)切分方式与模型架构相匹配。(英文原话:The cutting matches the model architecture.)”
来源访谈 →仅靠少数公式与简化的Roofline性能模型,就能推断出各大实验室正在做的很多工程选择。
“仅凭几个公式和一块黑板,我们竟能推断出实验室正在做的很多事情,这令人震惊。(英文原话:It's shocking how much you can deduce about what the labs are doing from a handful of equations and a blackboard)”
来源访谈 →金句墙 16 条
“If a true human-level software engineer could run on an H100 equivalent, then at today's prices for software engineers, that H100 should rent for over 250k a year.”
若人类级软件工程师能跑在H100上,按当前薪资水平,该卡年租金应超25万美元。
AI算力租价或暴涨15倍? · 2026/8/5“I wish we didn't live in a world with such strong economies of scale for intelligence because I'm worried about power concentration, but it seems we do.”
我宁愿我们生活的世界不存在如此强大的智能规模效应,因为我担忧权力集中,但现实似乎如此。
AI算力租价或暴涨15倍? · 2026/8/5“The value of compute is going to increase.”
算力的价值将持续攀升。
AI算力租价或暴涨15倍? · 2026/8/5“The big effect is batch size but what we're going to do now is quantify exactly what that looks like and what its implications are on latency and cost.”
最大的影响因素是批处理规模,接下来我们要精确量化它对延迟和成本的影响。
推理成本真相:批处理决定AI定价 · 2026/8/5“Pipelining totally solves the capacity problem, but scale up size helps solve the bandwidth problem.”
流水线并行完全解决了容量问题,但扩大机架内互联规模才能解决带宽问题。
推理成本真相:批处理决定AI定价 · 2026/8/5“I think it's like if you look at the history of context lengths of models... they shot up from about 8K to 100K 200K and then for the last year or two they've all been hovering around there. I think that actually indicates that that's sort of the reasonably balanced cost point.”
上下文长度从8K跃升至200K后便停滞不前,这恰恰说明那里是成本平衡点。
推理成本真相:批处理决定AI定价 · 2026/8/5“This is the single reason low-precision arithmetic has worked so well for neural nets.”
这是低精度算术在神经网络上如此有效的唯一原因。
从逻辑门到AI芯片:自底向上理解芯片设计 · 2026/5/22“Almost all your cost becomes synchronization or communication cost compared to the actual logic.”
与实际逻辑相比,你几乎所有的成本都变成了同步或通信成本。
从逻辑门到AI芯片:自底向上理解芯片设计 · 2026/5/22“A GPU is just a bunch of tiny TPUs.”
GPU本质上就是一堆微型TPU。
从逻辑门到AI芯片:自底向上理解芯片设计 · 2026/5/22“Make this one bigger somehow while keeping this at the same size. That's the goal.”
想办法把这个(计算单元)做大,同时保持那个(数据移动单元)不变。这就是目标。
从逻辑门到AI芯片:自底向上理解芯片设计 · 2026/5/22“It hurts your throughput, in fact, because the throughput of your chip is the product of how much you get done per clock cycle... times how many clocks you get per second.”
它实际上损害了你的吞吐量,因为芯片的吞吐量是每个时钟周期完成的工作量乘以每秒的时钟数。
从逻辑门到AI芯片:自底向上理解芯片设计 · 2026/5/22“It's shocking how much you can deduce about what the labs are doing from a handful of equations and a blackboard”
仅凭几个公式和一块黑板,我们竟能推断出实验室正在做的很多事情,这令人震惊。
从公式推演大模型训练与推理的数学原理 · 2026/4/29“Batch size is the big effect.”
批大小是关键影响因素。
从公式推演大模型训练与推理的数学原理 · 2026/4/29“One rack bounds the size of an expert layer you can do.”
一个机架(的物理规模)限制了你能运行的专家层的大小。
从公式推演大模型训练与推理的数学原理 · 2026/4/29“The cutting matches the model architecture.”
(硬件)切分方式与模型架构相匹配。
从公式推演大模型训练与推理的数学原理 · 2026/4/29“Pipelining is not wise.”
流水线并行并不明智。(引用 Ilya Sutskever)
从公式推演大模型训练与推理的数学原理 · 2026/4/29访谈收录
AI算力租价或暴涨15倍?
Reiner Pope是Dwarkesh Podcast主持人,本期他深入剖析AI实验室的收入与算力增长剪刀差。Anthropic连续三年收入同比增长10倍,但算力仅增3倍。他预测
推理成本真相:批处理决定AI定价
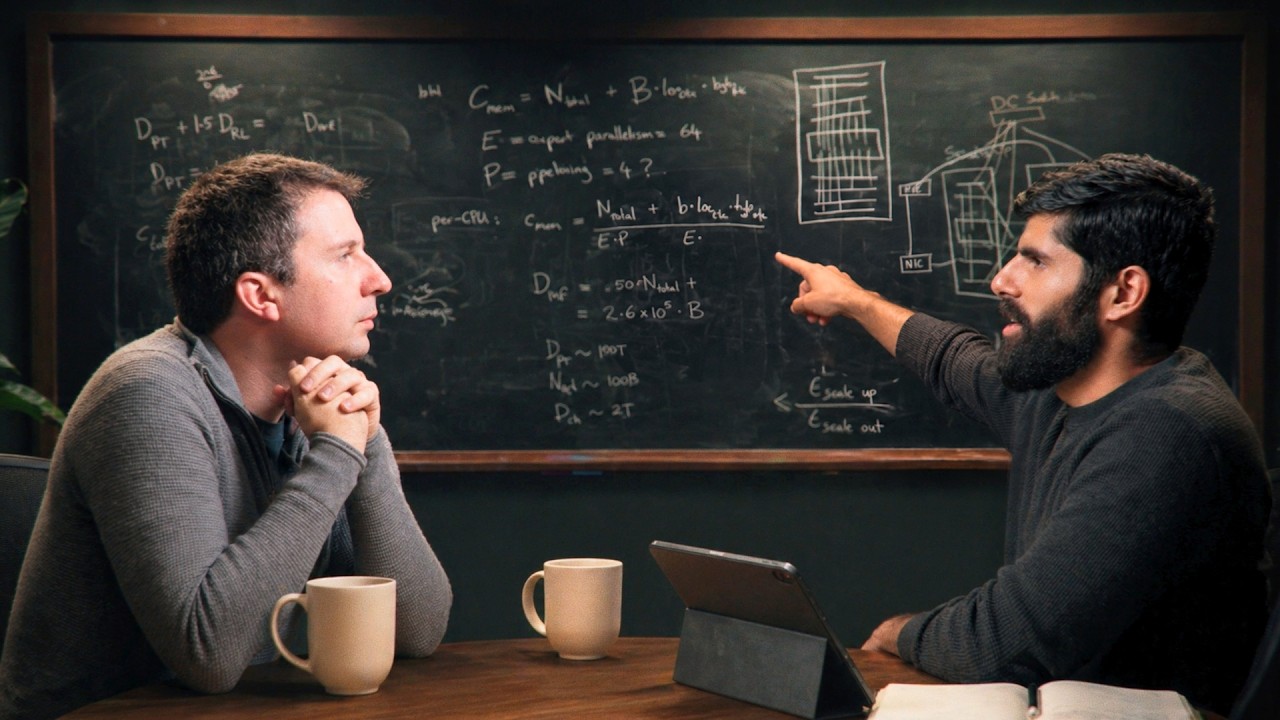
本期嘉宾Reiner Pope是芯片初创公司Maddox的CEO,曾在谷歌从事TPU架构等工作。在这期黑板讲座形式的访谈中,他系统拆解了大模型推理的底层物理规律——从批处理大小如何
从逻辑门到AI芯片:自底向上理解芯片设计
MatX CEO Reiner Pope 在访谈中从最底层的逻辑门开始,系统讲解了AI芯片的工作原理。他阐述了乘加运算作为核心原语的必然性、脉动阵列如何优化数据移动、时钟周期与流水线的权衡,以及GPU、TPU和FPGA在架构上的本质差异。
从公式推演大模型训练与推理的数学原理
MatX CEO Reiner Pope 在本次黑板讲座中,通过一系列基础公式和硬件参数,推导出大模型训练与推理中的关键优化原理。他量化了批大小、稀疏注意力、流水线并行等因素如何影响延迟与成本,并揭示了前沿实验室在模型部署时的实际考量与物理限制。